NuevoKervyn Embeddings y Kervyn Rerank, ya en Hugging Face

Modelos propios · español e inglés

IA propia que cabe en tu CPU.

Kervyn es una familia de modelos de lenguaje pequeños y bilingües, para desarrollo, analítica de datos y búsqueda semántica. Se sirven en tu infraestructura, sin GPU.

  • kervyn-dev · desarrollo
  • kervyn-data · analíticaPronto
  • kervyn-embed · búsquedaDisponible

Ilustración: tokens atravesando las capas de un transformer

200Mparámetros en kervyn-dev-flash, con 32k tokens de contexto
22,0 %de los problemas de HumanEval, resueltos al primer intento
94,45de nDCG@10 buscando con Kervyn Embeddings + Rerank, por encima de bge-m3 con su reranker
0 GPUnecesarias para servirlo

Modelos

Tres familias, una misma idea: pequeños, rápidos y tuyos

kervyn-dev

Para desarrollo

Escribe y explica código, SQL, JSON y ficheros de DevOps (Dockerfile, Kubernetes, Shell), y conversa en español e inglés.

  • kervyn-dev-nano 22M Pronto

    El más ligero de la familia.

  • kervyn-dev-flash 200M Acceso anticipado

    32k de contexto, pensado para CPU. HumanEval 22,0 % y MBPP 35,4 %.

    Antes: 110M y 8k, 77 MiB y 200–220 tok/s en CPU.

  • kervyn-dev-pro 1B Pronto

    1,09B parámetros: más calidad a cambio de algo de velocidad.

  • kervyn-dev-max 1B–3B Pronto

    El más capaz de la familia.
kervyn-data

Para analítica de datosPronto

Modelos especializados en analítica, con la misma filosofía: pequeños, bilingües y en tu infraestructura.

  • SQLEscribe y explica consultas sobre tus esquemas.
  • pandasLimpieza, transformación y análisis exploratorio.
  • informesResume resultados en lenguaje natural.

kervyn-embed

Para búsqueda semánticaDisponible

Un embedder y un reranker propios para buscar por significado, no por palabras sueltas, en español, en inglés y entre los dos. Ya están en Hugging Face con licencia Apache-2.0 y funcionan en CPU.

  • Kervyn Embeddings 100M 104M Preview · Apache-2.0

    Convierte cada texto en un vector de 768 números para buscar, también entre español e inglés. Responde en 26 ms por pregunta en CPU.

    Descargar en Hugging Face
  • Kervyn Rerank 100M 104M Preview · Apache-2.0

    Reordena los 20 primeros resultados de cualquier buscador y pone arriba el que responde: de +2,9 a +3,7 puntos de nDCG@10.

    Descargar en Hugging Face
  • búsquedaEncuentra funciones, documentación y tickets por lo que hacen, no por cómo se llaman.
  • RAGRecupera el contexto justo de tu repositorio o tu documentación antes de que un asistente responda.
  • ajuste finoAjústalos con pares pregunta-pasaje de tu empresa: caben en una GPU de consumo y el modelo ajustado es tuyo.

Por qué Kervyn

Hecho para correr donde ya está tu código

Privacidad

Tu código se queda en casa

Kervyn se aloja en tu infraestructura. Ninguna petición sale hacia proveedores externos.

Coste

Sin GPU, ni para servir

Se ejecuta en CPU con llama.cpp: basta un servidor modesto. La versión de 110M usa menos de 1 GB de RAM.

Integración

Habla el idioma de la API de OpenAI

Completions y chat con streaming. Tu cliente actual funciona cambiando la URL base y la clave.

Idiomas

Español e inglés, de serie

Entrenado desde cero con texto y código públicos en los dos idiomas, datos en español verificados y un bloque de DevOps.

Dentro del chip

Así funciona Kervyn por dentro

Cada familia usa la red para una cosa distinta. Elige una para ver sus capas y qué sale por arriba.

kervyn-dev-flash es un transformer de 200M parámetros con 32k tokens de contexto, crecido desde el de 110M. Estas son sus capas reales: el texto entra por abajo, atraviesa 32 bloques y sale convertido en el siguiente token.

kervyn-data está en preparación. Cuando esté entrenado, aquí verás sus capas y cómo convierte tus preguntas en consultas y análisis.

Kervyn Embeddings 100M no escribe: lee. Es un encoder bidireccional propio de 104M parámetros: el texto atraviesa sus 12 capas y sale resumido en un vector de 768 números, y los textos con significado parecido dan vectores cercanos, también entre español e inglés.

Ilustración con los 32 bloques reales de kervyn-dev-flash; las predicciones son de ejemplo. Ilustración con las 12 capas reales de Kervyn Embeddings 100M; el vector y el resultado son de ejemplo. El chip de kervyn-data se abrirá cuando el modelo esté entrenado.
  1. 04 Salida0 parámetros extra

    Elige el siguiente token

    Una RMSNorm final y la cabeza de salida puntúan los 24.576 tokens del vocabulario. Reutiliza la matriz de embeddings (pesos atados), así que no añade parámetros.

  2. 03 32 bloques transformer5,70M × 32

    Atención sobre todo el contexto

    Cada bloque combina atención con 12 cabezas de consulta y 4 de clave/valor (GQA, con posiciones RoPE) y una red SwiGLU de 768 → 1.792 → 768. Mira hasta 32k tokens hacia atrás. 16 de ellos se añadieron al crecer desde el 110M.

  3. 02 Embeddings18,9M

    Cada token, un vector de 768 números

    Una tabla de 24.576 × 768 convierte cada token en un punto de un espacio donde lo parecido queda cerca.

  4. 01 Tokenizer24.576 tokens

    Del texto a tokens

    BPE a nivel de byte entrenado con nuestro corpus de código, español e inglés. Ningún carácter se queda fuera, ni acentos ni emojis.

  1. 04 Vector768 números

    Textos parecidos, vectores cercanos

    Sale un vector normalizado por texto. Se compara con el coseno para buscar, agrupar o recuperar contexto, también entre idiomas.

  2. 03 Pooling

    Todo el texto en un solo punto

    Hace la media de todos los tokens: en vez de predecir el siguiente, resume la secuencia completa en un único vector.

  3. 02 Encoder bidireccional12 × 768

    Cada token, en todo su contexto

    A diferencia de kervyn-dev, cada token mira a los de antes y a los de después, con 12 cabezas de atención y posiciones RoPE.

  4. 01 Tokenizer~24.600 tokens

    Del texto a tokens

    Propio, entrenado con español, inglés y código. La consulta o el pasaje se parte en tokens, hasta 512 por texto.

Pronto

El chip de kervyn-data todavía está cerrado

Lo abriremos con sus capas y sus cifras reales cuando el modelo esté entrenado. Será la familia para SQL, pandas e informes.

Parámetros
200M
Bloques
32
Dimensión
768
Cabezas Q / KV
12 / 4
Contexto
32k
HumanEval
22,0 %
Parámetros
104M
Capas
12 × 768
Vector
768
Licencia
Apache-2.0

Cómo entrenamos kervyn-dev-flash

  1. Preentreno

    Texto en español e inglés y código públicos: aprende a predecir el siguiente token.

    ~1-2B tokens · bpb 0,99
  2. Código

    Dos rondas de preentreno continuado con código público descontaminado y un bloque de DevOps.

    1,97B + 2,36B tokens
  3. Crecer

    De 16 a 32 capas. Las nuevas empiezan como identidad, así que el modelo no pierde nada de lo aprendido.

    110M → 200M
  4. Más código y 32k

    Una tercera ronda de código sobre el modelo crecido y la ventana de 8k a 32k, con RoPE θ = 10⁶.

    4,16B tokens · 32k
  5. Chat

    SFT con 304k ejemplos públicos, 18.787 de tutores verificados por ejecución y robustez de chat.

    HumanEval 22,0 % · MBPP 35,4 %
  6. A la CPU

    Si pasa la puerta de evaluación, se exporta a GGUF y se sirve con llama.cpp, sin GPU.

    Q8_0 · Q4_K_M

Cómo entrenamos Kervyn Embeddings 100M

  1. Preentreno desde cero

    Web y Wikipedia en español e inglés, más de la mitad en español, con un ~10 % de código.

    48.000M tokens
  2. Pares débiles

    Títulos y cuerpos, preguntas y respuestas, frases paralelas ES↔EN, noticias, legislación y artículos científicos.

    contrastivo
  3. Supervisado

    Queries con negativos difíciles; Kervyn Rerank limpia los falsos negativos y aporta sus puntuaciones.

    2,6M queries
  4. Publicado

    En Hugging Face como modelo sentence-transformers, sin destilar ningún embedder de terceros.

    Apache-2.0

Cómo se usa: búsqueda en dos etapas

  1. Indexa

    Trocea tus documentos en pasajes de ~200 palabras y guarda sus vectores.

    13 pasajes/s en 8 vCPU
  2. Pregunta

    La consulta pasa por el mismo modelo, sin prefijos, y se convierte en otro vector.

    26 ms por pregunta
  3. Busca

    Se recuperan los 20 pasajes más cercanos, aunque la pregunta esté en español y el pasaje en inglés.

    similitud del coseno
  4. Reordena

    Kervyn Rerank lee la pregunta y cada pasaje juntos, y pone primero el que responde.

    +2,9 a +3,7 nDCG@10
  5. Responde

    Los pasajes se muestran como resultados o se pasan a kervyn-dev como contexto (RAG).

    todo en tu CPU

Train your own KervynPronto

Entrena tu propio Kervyn con tu código y tus datos

Pronto podrás partir del modelo base y continuar su entrenamiento con los repositorios, la documentación o los datasets de tu empresa. El resultado conocerá tus APIs, tus convenciones y tu dominio, y no saldrá de tu infraestructura.

Tu código y tus datos entran en el modelo base; sale un Kervyn que los conoce.
  1. Reúne tu material

    Repositorios, documentación interna o datasets. El inventario mide cuánto hay de cada lenguaje antes de entrenar nada.

  2. Limpia y protege

    El pipeline elimina claves de API, claves privadas y credenciales antes de tokenizar. Una lista de términos sensibles bloquea la exportación si se cuela alguno.

  3. Continúa el entrenamiento

    Se parte de los pesos del modelo base y se ajusta con tu material; después viene el ajuste de chat.

  4. Evalúa con tus casos

    Pruebas ejecutables: valida JSON contra un esquema, ejecuta el SQL en SQLite y corre Python y JavaScript con límite de tiempo.

  5. Despliégalo

    Exporta a GGUF y sírvelo en tu CPU con la misma API compatible con OpenAI.

así funcionará el proceso
# Inventario de tu código (no entrena nada)
kervyn inventory --roots ./repos ./docs

# Tokenizar con el tokenizer de Kervyn
kervyn prepare --roots ./repos ./docs \
  --tokenizer tokenizer/kervyn-24k-public.json \
  --out data/mi-empresa --val-fraction 0.03

# Continuar desde el modelo base
kervyn train --config configs/mi-empresa.yaml \
  --data data/mi-empresa --out runs/mi-empresa \
  --init-from runs/kervyn-dev-flash/best.pt

# Evaluar y exportar
kervyn eval-exec --ckpt runs/mi-empresa/best.pt \
  --cases mis-casos.jsonl --out eval/mi-empresa.jsonl
kervyn export --ckpt runs/mi-empresa/best.pt \
  --out deploy/mi-kervyn

Para búsqueda ya puedes hacerlo: Kervyn Embeddings y Kervyn Rerank se ajustan con pares pregunta-pasaje de tu empresa en una GPU de consumo, y sus fichas en Hugging Face traen el código.

Como referencia, nuestro pipeline entrena a ~259.000 tokens/s en una sola GPU alquilada de 96 GB, el doble que antes de añadir la atención por documento y torch.compile. Podrás entrenar en tus propias máquinas o en una GPU que controles.

Avísame cuando esté listo

Integración

Tres pasos para tenerlo en marcha

  • /v1/completions
  • /v1/chat/completions
  • stream: SSE
  • Bearer API key
  • /health
  • /readyz
  • /v1/models
  • /metrics
Encapsulado GGUF · contexto de 32k tokens · API compatible con OpenAI
  1. Arranca el servidor

    llama.cpp sirve el modelo GGUF, que ya lleva dentro la plantilla de chat de Kervyn.

  2. Apunta tu cliente

    Usa la dirección de tu servidor como URL base del cliente OpenAI y añade la API key.

  3. Ponle TLS delante

    Caddy o Cloudflare aportan HTTPS y límite de peticiones. No hace falta GPU ni Kubernetes.

servidor + petición de ejemplo
# 1. Servidor en CPU
llama-server -m kervyn-dev-flash-Q8_0.gguf -c 32768 \
  --temp 0.2 --repeat-penalty 1.1 \
  --api-key "$KERVYN_KEY" --port 8080

# 2. Petición compatible con OpenAI
curl http://localhost:8080/v1/chat/completions \
  -H "Authorization: Bearer $KERVYN_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model": "kervyn",
       "messages": [{"role": "user",
                     "content": "Explica qué es JSON"}],
       "max_tokens": 200}'

Rendimiento

Medido con las mismas pruebas, versión a versión

Velocidad en CPU y benchmarks públicos descontaminados. Las cifras salen del Paper n.º 1 de Kervyn y de las fichas de los modelos publicados en Hugging Face.

Velocidad en CPU · versión de 110M y 8k
FormatoTamañoPrompt 8kGeneración
GGUF Q4_K_Mel más ligero 77 MiB ~540 tok/s 200–220 tok/s
GGUF Q8_0más fiel al original 131 MiB ~460 tok/s 120–180 tok/s

llama.cpp con 6 hilos y menos de 1 GB de RAM. Con un prompt de 512 tokens se leen ~1.500 tok/s (Q4_K_M) y ~1.020 tok/s (Q8_0). La velocidad del 200M se medirá antes de publicarlo.

Programación · pass@1
VersiónHumanEvalMBPP
110M · SFT v27 nov · antes de la auditoría1,8 %0,0 %
110M · CPT 2base · código y DevOps10,4 %21,8 %
110M · SFT v6robustez de chat14,0 %33,5 %
200M · SFT v79 nov · datos de tutores22,0 %35,4 %

HumanEval (164) y MBPP sanitized (257), greedy y ejecutando los tests. Sin los problemas que aparecen en el entrenamiento, el 110M v5full saca 12,5 % y 30,5 %.

Búsqueda · Kervyn Embeddings 100M · nDCG@10
TareaKervyne5-smalle5-basebge-m3
Parámetros104M118M278M568M
Belebele ES92,1992,7094,1993,96
Belebele ES→EN90,1386,9589,4691,99
XQuAD ES→EN94,5394,8996,1596,15
kervyn-docs documentación técnica en español75,7871,9676,0774,50
CodeSearchNet Python90,0886,3185,6885,31
Media de búsqueda (8)91,0290,1991,5791,41
STS17 ES-EN similitud de frases77,9672,4376,5675,57
Búsqueda en dos etapas · reordenando el top-20
SistemaParámetrosMedia (8)Sin código (7)
Kervyn Embeddings + Kervyn Rerank208M94,4594,83
bge-m3 + bge-reranker-v2-m31.136M94,1895,86

e5 = multilingual-e5. ES→EN: pregunta en español y pasaje en inglés. En texto sin código, la pareja bge, con 5 veces más parámetros, queda ~1 punto por delante. En CPU (8 vCPU, fp32), Kervyn Embeddings responde en 26 ms por pregunta y Kervyn Rerank reordena un top-20 en 2,5 s, 2,8 veces más rápido que bge-reranker-v2-m3.

Investigación

Lo que aprendemos, publicado con cifras reales

Kervyn es un proyecto de investigación: cada avance se publica en un paper numerado, con lo que se entrenó, cómo se midió y qué salió mal.

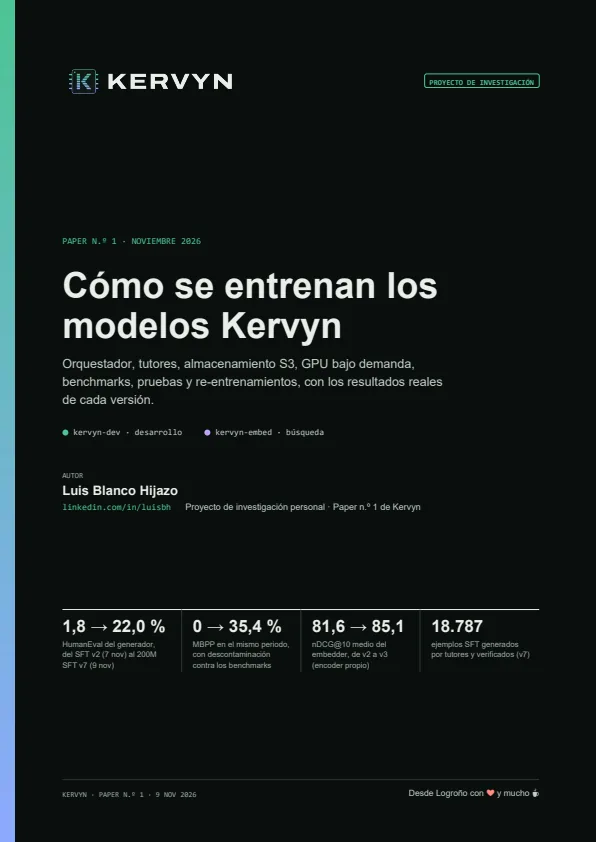
Paper n.º 19 nov 202615 páginas

Cómo se entrenan los modelos Kervyn

Orquestador, tutores, almacenamiento S3, GPU bajo demanda, benchmarks, pruebas y re-entrenamientos, con los resultados reales de cada versión.

Por Luis Blanco Hijazo · LinkedIn

  • 1,8 → 22,0 %HumanEval del generador, del 7 al 9 de noviembre
  • 0 → 35,4 %MBPP en el mismo periodo, con descontaminación
  • 81,6 → 85,1nDCG@10 medio de kervyn-embed, de v2 a v3
  • 18.787ejemplos de tutores, verificados por ejecución
Qué contiene
  1. Qué se entrena y con qué reglas
  2. Quién hace qué
  3. El ciclo de entrenamiento
  4. Datos: públicos y de tutores
  5. Un S3 como fuente única
  6. Cómputo bajo demanda
  7. Las recetas de entrenamiento
  8. Benchmarks y pruebas
  9. Resultados reales, versión a versión
  10. Re-entrenamientos: cuatro casos reales
  11. Estado actual y próximos pasos

Cómo citarlo

Blanco Hijazo, L. (2026). Cómo se entrenan los modelos Kervyn. Paper n.º 1 de Kervyn, noviembre de 2026.

ProntoPaper n.º 2: el 200M con SFT v7b, el benchmark final de kervyn-embed v3 y el primer paso hacia kervyn-dev-pro 1B.

Colabora

Kervyn crece con su comunidad

Los modelos se entrenan desde cero con datos públicos, con la licencia de cada fuente anotada, y con la ayuda de quien quiera sumar. Hay cuatro formas de hacerlo.

Código

Aporta repositorios

Propón repositorios públicos con licencia permisiva para el corpus de entrenamiento. Revisamos la licencia de cada uno antes de usarlo.

Empresas

Dona como empresa

Financia horas de GPU, preparación de datos o evaluación. Escríbenos y vemos juntos cómo encaja.

Escribir para donar
Café

Invítanos a un café

Si Kervyn te resulta útil, un café ayuda a pagar las próximas horas de entrenamiento.

Buy me a coffee
Infraestructura

Ofrece infraestructura

¿Tienes GPUs, almacenamiento o cómputo disponible? Con tu capacidad podemos entrenar modelos más grandes, como kervyn-dev-pro y kervyn-data.

Contactar

Contacto directo: